/**
* @Description:
* @Version: 1.0
*/
import org.wltea.analyzer.core.IKSegmenter;
import org.wltea.analyzer.core.Lexeme;
import java.io.IOException;
import java.io.StringReader;
import java.util.*;
public class Test {
/**
* 对语句进行分词
* @param text 语句
* @return 分词后的集合
* @throws IOException
*/
private static Map segment(String text) throws IOException {
Map<String,Integer> map = new HashMap<String,Integer>();
StringReader re = new StringReader(text);
IKSegmenter ik = new IKSegmenter(re, false);//true 使用smart分词,false使用最小颗粒分词
Lexeme lex; while ((lex = ik.next()) != null) { if(lex.getLexemeText().length()>1){ if(map.containsKey(lex.getLexemeText())){ map.put(lex.getLexemeText(),map.get(lex.getLexemeText())+1); }else{ map.put(lex.getLexemeText(),1); } } } return map; } public static void main(String[] args) throws IOException { Map<String,Integer> map = segment("中国,中国,我爱你"); System.out.println(map.toString()); } }
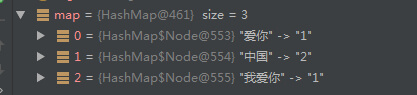
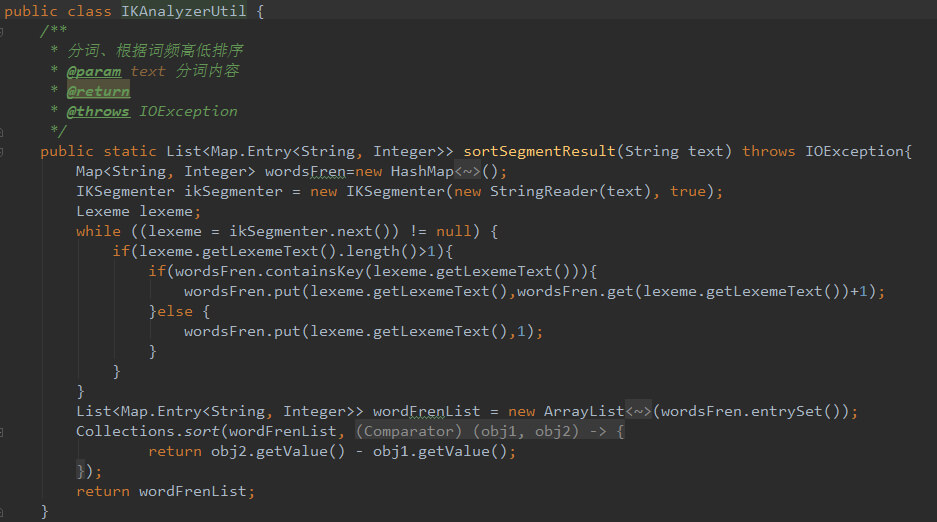
输出结果: * [5 z5 |" n' u* w+ Q, J2 a, W$ L S0 H1 I 整理简单工具类,代码如下:" z6 _& O8 m. Y/ p: u* Z& o
T% V7 i/ K' ~/ v& d
, N& F4 J" H$ i7 m! ? IKanalyzer分词器源码下载>>' F' v. t, `/ d$ H( u* i
 |手机版|小黑屋|paopaomj.COM
(
 渝ICP备18007172号|
 渝公网安备50010502503914号 )


 发表于 2021-2-6 19:51:30